Standardabweichung Rechner

Standardabweichung & Varianz Rechner

Berechnen Sie Stichproben- und Populations-Standardabweichung, Varianz, Mittelwert und Fehlermarge sofort. Mit Normalverteilung und Ausreißererkennung.

Voreinstellungen:
Eingabesteuerung & Konfiguration
30 Gültige Datenpunkte
Berechnungsmodus (Freiheitsgrade)
Statistisches Konfidenzniveau
Ausreißerbehandlung
Tukey-Faktor (k × IQR)1.5x IQR
Sensitiv (1,0 × IQR)Standard (1,5 × IQR)Extrem (3,0 × IQR)
Bessel-Korrektur & Unverzerrte Varianz

Die Bessel-Korrektur teilt durch (n - 1) statt n, um die systematische Unterschätzung der Grundgesamtheitsvarianz in Stichproben mathematisch zu neutralisieren.

In Sport, Herzfrequenzvariabilität (HRV) und Schlafqualität steht eine geringe Standardabweichung für verlässliche Konstanz, während höhere Werte stärkere Schwankungen signalisieren.

Stichproben-Standardabweichung (s)n - 1
7.9997
Stichprobenvarianz (s²): 63.9954
Populations-Standardabweichung (σ)N
7.8653
Populationsvarianz (σ²): 61.8622
Arithmetischer Mittelwert (x̄)Σx / n
82.9333
Summe (Σx): 2,488 (n = 30)
Standardfehler des Mittelwerts (SE)1.4605
Variationskoeffizient (CV)9.65%
Median (Q2)83.5
Interquartilsabstand (IQR)12
Konfidenzintervall des Mittelwerts (95%)x̄ ± 2.9868 (t* = 2.045)
[79.9465to85.9201]
Schiefe (Skewness)-0.21Approximately Symmetrical
Exzess-Wölbung (Kurtosis)-0.906Platykurtic (Light tails)
Anzahl Beobachtungen (n)30
Arithmetischer Mittelwert (x̄)82.9333
Stichproben-Standardabweichung (s)7.9997
Standardfehler des Mittelwerts (SE)1.4605
Median (Q2)83.5
Fehlermarge (±E)±2.9868
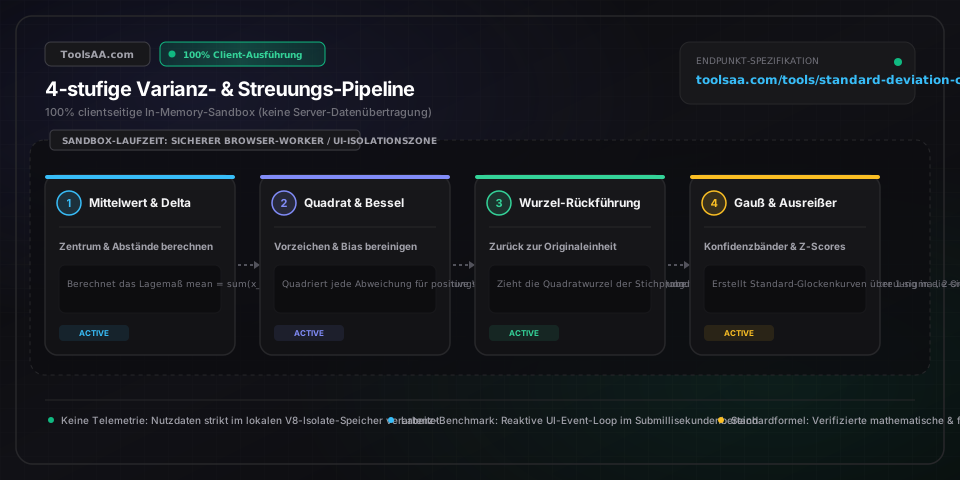
Technische Referenz & Architektur-Leitfaden

Standardabweichung & Varianz Rechner — Referenzhandbuch

Berechnen Sie Stichproben- und Populations-Standardabweichung, Varianz, Mittelwert und Fehlerspanne in Echtzeit. Datensätze präzise bereinigen mit Ausreißererkennung und Normalverteilung.

Standardabweichung & Varianz Rechner — Referenzhandbuch — Client-seitige In-Memory-Architektur und Datenfluss

Wichtige Parameter & Einstellungen

Stichproben-Standardabweichung (s)Statistischer Streuungsschätzer

Misst die Streuung um den Stichprobenmittelwert unter Anwendung der Bessel-Korrektur (Division durch n - 1). Diese mathematische Anpassung verhindert eine systematische Unterschätzung der realen Streuung bei Stichproben – wie etwa den wöchentlichen 5-km-Zwischenzeiten eines Läufers, Klausurergebnissen eines Semesters oder den monatlichen Ausgaben für Lebensmittel.

Standard: Erwartungstreu (n - 1 Freiheitsgrade)
Populations-Standardabweichung (σ)Parametrische Streuungskonstante

Quantifiziert die exakte Streuung einer vollständigen Grundgesamtheit durch Division der quadrierten Abweichungen durch N. Streng gültig nur dann, wenn jedes einzelne Element der Gesamtheit ohne Schätzung gemessen wird – etwa alle 28 Schüler einer festen Schulklasse, sämtliche 12 Stromrechnungen eines Kalenderjahres oder jeder Herzschlag während eines absolvierten Wettkampfs.

Standard: Exakter Parameter (N Freiheitsgrade)
Stichprobenvarianz (s²)Mittlere quadratische Abweichung

Der durchschnittliche quadrierte Abstand jedes Messwerts zum arithmetischen Mittel, angegeben in quadrierten Einheiten (z. B. Sekunden² oder Punkte²). Zwar ist die Varianz im Trainingsalltag oder Haushaltsbudget weniger intuitiv als die Standardabweichung, sie fungiert jedoch als fundamentales additives Fundament für Varianzanalysen und Konsistenzvergleiche im Sport und in der Leistungsdiagnostik.

Standard: Summe der quadrierten Abweichungen / (n - 1)
Standardfehler des Mittelwerts (SE)Stichproben-Präzisionsindikator

Gibt an, wie präzise der Stichprobenmittelwert den wahren Mittelwert der Grundgesamtheit widerspiegelt, berechnet als s / √n. Während die Standardabweichung die natürliche Streuung einzelner Messwerte (z. B. täglicher Ruhepuls) beschreibt, quantifiziert der Standardfehler die Verlässlichkeit des Gesamtdurchschnitts und schrumpft mit jeder weiteren dokumentierten Trainingseinheit oder Messreihe.

Standard: Präzisionsindex s / √n
Variationskoeffizient (CV)Normierte relative Streuung

Das Verhältnis von Standardabweichung zu Mittelwert in Prozent: (s / Mittelwert) × 100 %. Liefert einen maßstabsunabhängigen Vergleichswert für Datensätze völlig unterschiedlicher Größenordnung – etwa beim Vergleich der Herzratenvariabilität im Tiefschlaf (Mittelwert 60 bpm, s = 3 bpm, CV = 5 %) mit hochintensiven Intervallsprints (Mittelwert 170 bpm, s = 8,5 bpm, CV = 5 %).

Standard: Prozentuales Streuungsverhältnis ((s / Mittelwert) × 100 %)
Interquartilsabstand (IQR)Nicht-parametrisches Streuungsmaß

Die Spanne zwischen dem 75. Perzentil (Q3) und dem 25. Perzentil (Q1), welche die mittleren 50 % der Messwerte umfasst. Da der IQR unempfindlich gegenüber extremen Ausreißern durch einmalige GPS-Messfehler, Fehlmessungen oder saisonale Ausgabenspitzen ist, dient er im klinischen und sportwissenschaftlichen Kontext als robuster Maßstab für Ausreißertests nach Tukey (1,5 × IQR-Grenzen).

Standard: Q3 - Q1 mittlere 50 %-Spanne

Profi-Tipps & Best Practices

Katastrophale Auslöschung bei Kurzformeln

Vermeiden Sie bei Zahlen mit hohen Basiswerten und minimaler Streuung die vereinfachte Verschiebeformel (Summe von x² - (Summe von x)² / n), beispielsweise bei GPS-Höhenmarken (1.842,1 m; 1.842,3 m) oder Marathon-Transponderzeiten. Das Subtrahieren zweier riesiger, nahezu identischer Summen führt zu einem drastischen Verlust an Dezimalpräzision durch Stellenauslöschung. Berechnen Sie stattdessen stets zuerst das arithmetische Mittel, bestimmen Sie die Abweichung jedes Einzelwerts und quadrieren Sie diese Differenzen.

Grenzen der Drei-Sigma-Regel bei schiefen Verteilungen

Die klassische 68-95-99,7-Prozent-Regel setzt zwingend eine symmetrische, glockenförmige Gauß-Verteilung voraus. Bei realen Kennzahlen im Alltag – wie monatlichen Sparraten, Regenerationsstunden zwischen Marathon-Trainingsblöcken oder Verzögerungen im Berufsverkehr – ist die Verteilung rechtsschief und besitzt ein physikalisches Minimum bei null. Wendet man ±2 Standardabweichungen auf solche Daten an, entstehen unmögliche negative Grenzen; nutzen Sie hier stattdessen Median und Interquartilsabstand (IQR).

Systematische Unterschätzung der Streuung bei kleinen Datenreihen

Obwohl die Bessel-Korrektur (Division durch n - 1) die Stichprobenvarianz (s²) erwartungstreu macht, führt das anschließende Ziehen der Quadratwurzel aufgrund der Jensenschen Ungleichung zu einer leichten systematischen Unterschätzung der Standardabweichung (s). Bei sehr kleinen Stichproben unter 10 Messwerten – wie 5 Sprint-Wiederholungen oder 7 morgendlichen Blutdruckmessungen – unterschätzt die berechnete Standardabweichung die reale Streuung der Grundgesamtheit typischerweise um 3 % bis 6 %.

Gesetz des abnehmenden Ertrags beim Stichprobenumfang

Da der Standardfehler proportional zur Quadratwurzel des Stichprobenumfangs schrumpft (√n), erfordert eine Halbierung der Fehlerspanne eine Vervierfachung der Messwerte. Erhöhen Sie Ihre dokumentierten Laufeinheiten oder Tankbelege von 10 auf 40 Einträge, sinkt die Schätzunsicherheit um 50 %; ein weiterer Anstieg von 40 auf 70 Einträge verbessert die Präzision jedoch nur noch um rund 18 %. Setzen Sie auf konsistente, valide Datenerhebung statt auf bloße Datenmenge.

Häufige Fehlerquellen & Fehlerbehebung

⚠️Stichproben-Standardabweichung liefert 'Nicht definiert' oder Division durch Null

Die Berechnung der Stichproben-Standardabweichung erfordert mindestens zwei unterschiedliche Messpunkte (n ≥ 2), da die Bessel-Korrektur durch (n - 1) dividiert. Bei Eingabe nur eines einzelnen Werts (n = 1) sinkt die Anzahl der Freiheitsgrade auf null, wodurch die Varianz mathematisch unbestimmt ist. Schalten Sie auf den Populationsmodus um, wenn Sie ein einzelnes, vollständiges Ereignis analysieren (wobei N = 1, σ = 0), oder erfassen Sie weitere Stichprobenwerte.

⚠️Standardabweichung ergibt exakt Null (s = 0)

Eine Standardabweichung von genau null zeigt an, dass alle eingegebenen Messwerte absolut identisch sind (z. B. vier aufeinanderfolgende Rundenzeiten von jeweils exakt 62,0 Sekunden). Das ist rechnerisch korrekt und steht für perfekte Konsistenz, führt jedoch in nachgelagerten normierten Formeln wie dem Variationskoeffizienten (CV) oder Z-Scores zu Fehlern durch Division durch Null.

⚠️Reale Spitzenleistungen werden fälschlicherweise als Ausreißer markiert

Klassische Ausreißerfilter stufen jeden Wert außerhalb von 1,5 × IQR als Anomalie ein, was eine balancierte Normalverteilung unterstellt. Im echten Trainings- und Alltagsverlauf – etwa bei gewollten Spitzen im Intervalltraining oder einer winterlichen Heizkostenabrechnung – sind rechtsschiefe Spitzen völlig normal. Erhöhen Sie die Ausreißerschwelle auf 3,0 × IQR (äußere Grenze nach Tukey) oder verifizieren Sie die Werte anhand Ihres Trainingstagebuchs, bevor Sie valide Daten verwerfen.

⚠️Untere Grenze des Konfidenzintervalls fällt unter physikalische Nullgrenzen

Symmetrische Konfidenzintervalle (Mittelwert ± Fehlerspanne) unterstellen, dass Abweichungen nach oben und unten gleich wahrscheinlich sind. Bei kleinem Mittelwert und hoher Streuung – etwa bei wöchentlich verpassten Trainingseinheiten oder Reparaturfällen am Auto – kann die rechnerische Untergrenze in den negativen Bereich rutschen. Kappen Sie die untere Schranke manuell bei null oder weichen Sie bei physikalisch nicht-negativen Daten auf nicht-parametrische Perzentilintervalle aus.

Häufig gestellte Fragen (FAQ)

Wie berechnet man die Standardabweichung Schritt für Schritt?▼

Zur Berechnung der Stichproben-Standardabweichung ermitteln Sie zunächst das arithmetische Mittel aller Werte, subtrahieren den Mittelwert von jedem Einzelwert, quadrieren jede dieser Differenzen, summieren alle quadrierten Werte, teilen die Summe durch n - 1 (Bessel-Korrektur) und ziehen daraus die positive Quadratwurzel: s = √[ Σ(x - Mittelwert)² / (n - 1) ]. Beispiel mit den Werten 4, 8 und 12: Der Mittelwert beträgt 8; die quadrierten Differenzen zu 8 sind 16, 0 und 16 (Summe 32); geteilt durch (3 - 1 = 2) ergibt sich eine Varianz von 16 und somit eine Standardabweichung von 4.

Was gilt als gute oder normale Standardabweichung?▼

Was als 'gut' gilt, hängt immer von der Größenordnung des Mittelwerts ab und wird über den Variationskoeffizienten quantifiziert (CV = s / Mittelwert × 100 %). Im Ausdauersport und bei Ruhe-Biometriedaten steht ein CV unter 5 % bis 8 % für herausragende Beständigkeit, während 10 % bis 15 % bei Hobbyläufern und im Fitnesstracking typisch sind. In der industriellen Fertigung (DIN-Normen) oder medizinischen Dosierung sind Werte unter 1 % bis 2 % zwingend erforderlich, während volatile Finanzanlagen nicht selten relative Streuungen von über 30 % aufweisen.

Worin liegt der Unterschied zwischen Standardabweichung und Varianz?▼

Die Varianz misst die mittlere quadratische Streuung in quadrierten Einheiten (wie Sekunden² oder Euro²), während die Standardabweichung die Quadratwurzel der Varianz bildet und die Streuung in der ursprünglichen Maßeinheit Ihrer Daten ausdrückt (z. B. Sekunden oder Euro). Während die Varianz die mathematische Grundlage für Varianzanalysen (ANOVA) und Regressionsmodelle darstellt, liefert die Standardabweichung eine anschauliche, direkt mit Ihren Alltagsmessungen vergleichbare Kennzahl.

Worin unterscheidet sich die Standardabweichung vom Standardfehler?▼

Die Standardabweichung misst die natürliche Streuung einzelner Messwerte innerhalb eines Datensatzes. Der Standardfehler des Mittelwerts (SE = s / √n) hingegen beziffert, wie exakt der ermittelte Stichprobenmittelwert den wahren Mittelwert der Grundgesamtheit widerspiegelt. Die Standardabweichung beschreibt die Datenverteilung und bleibt bei wachsendem Stichprobenumfang weitgehend stabil, während der Standardfehler die Schätzpräzision angibt und mit steigender Messwertanzahl kontinuierlich gegen null sinkt.

Warum teilt man bei der Stichproben-Standardabweichung durch n minus 1 statt durch n?▼

Man teilt durch n - 1 (bekannt als Bessel-Korrektur), weil Stichprobenwerte naturgemäß näher an ihrem eigenen Stichprobenmittelwert liegen als am wahren, unbekannten Mittelwert der Gesamtheit. Da das arithmetische Mittel direkt aus den Daten berechnet wird, entsteht eine mathematische Bindung (die Summe aller Abweichungen ist immer null), wodurch ein Freiheitsgrad verloren geht. Eine Division durch n würde die Streuung systematisch unterschätzen; die Division durch n - 1 korrigiert diese Verzerrung exakt und liefert einen erwartungstreuen Schätzer.

Verwandte Tools & Hilfsprogramme

Alle Tools →