Calculateur d'Écart-Type

Calculateur d'Écart-Type & Variance

Calculez instantanément l'écart-type d'échantillon et de population, la variance, la moyenne et la marge d'erreur. Détection des valeurs aberrantes et courbe de Gauss.

Préréglages :
Panneau de saisie & Configuration
30 Points numériques valides
Régime de calcul (Degrés de liberté)
Niveau de confiance statistique
Traitement des valeurs aberrantes
Facteur de Tukey (k × IQR)1.5x IQR
Sensible (1,0 × IQR)Standard (1,5 × IQR)Extrême (3,0 × IQR)
Correction de Bessel & Degrés de liberté

La correction de Bessel divise par (n - 1) au lieu de n, compensant le biais naturel de sous-estimation de la variance d'une population à partir d'un échantillon.

En santé, variabilité de fréquence cardiaque (VFC) ou sommeil, un faible écart-type reflète une régularité solide, tandis qu'un écart élevé révèle de fortes oscillations.

Écart-type d'échantillon (s)n - 1
7.9997
Variance d'échantillon (s²): 63.9954
Écart-type de population (σ)N
7.8653
Variance de population (σ²): 61.8622
Moyenne arithmétique (x̄)Σx / n
82.9333
Somme (Σx): 2,488 (n = 30)
Erreur standard (SE)1.4605
Coefficient de variation (CV)9.65%
Médiane (Q2)83.5
Écart interquartile (IQR)12
Intervalle de confiance de la moyenne (95%)x̄ ± 2.9868 (t* = 2.045)
[79.9465to85.9201]
Asymétrie de Fisher-Pearson-0.21Approximately Symmetrical
Aplatissement (Kurtosis)-0.906Platykurtic (Light tails)
Effectif total (n)30
Moyenne arithmétique (x̄)82.9333
Écart-type d'échantillon (s)7.9997
Erreur standard (SE)1.4605
Médiane (Q2)83.5
Marge d'erreur (±E)±2.9868
Référence technique et guide d'architecture

Calculateur d'écart-type & variance — Guide de référence

Calculez instantanément l'écart-type d'échantillon et de population, la variance, la moyenne et la marge d'erreur. Détectez les valeurs aberrantes et visualisez la courbe normale.

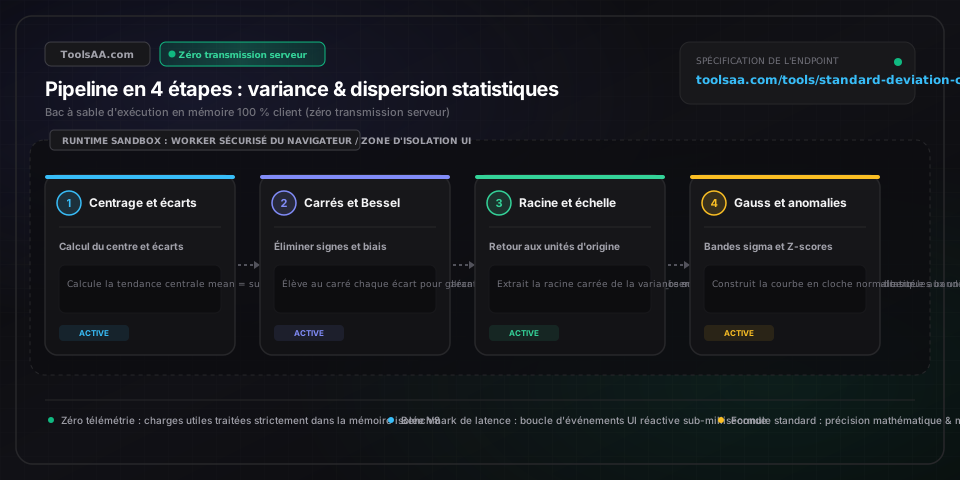
Calculateur d'écart-type & variance — Guide de référence — Architecture en mémoire côté client et flux de données

Paramètres clés et contrôles

Écart-type de l'échantillon (s)Estimateur de dispersion statistique

Mesure la variabilité autour de la moyenne d'un échantillon en appliquant la correction de Bessel (division par n - 1). Cet ajustement évite de sous-estimer la dispersion réelle lors de l'analyse d'un sous-ensemble, comme les temps au kilomètre d'un coureur sur ses 5 km hebdomadaires, les notes semestrielles d'un étudiant ou les dépenses mensuelles de courses d'un foyer.

Par défaut : Sans biais (n - 1 degrés de liberté)
Écart-type de la population (σ)Constante de dispersion paramétrique

Quantifie la dispersion réelle d'un ensemble complet fermé en divisant la somme des écarts au carré par N. Valable uniquement lorsque chaque entité de l'univers défini est mesurée sans extrapolation, comme l'ensemble des 30 élèves d'une classe, les 12 factures d'électricité d'une année civile ou chaque pulsation cardiaque enregistrée lors d'une course terminée.

Par défaut : Paramètre exact (N degrés de liberté)
Variance de l'échantillon (s²)Métrique de déviation quadratique moyenne

Moyenne des carrés des écarts de chaque observation par rapport à la moyenne arithmétique, exprimée en unités au carré (comme des secondes² ou des euros²). Moins intuitive pour l'allure sportive ou le budget quotidien que l'écart-type, la variance constitue le moteur additif fondamental pour comparer la régularité de groupes à l'entraînement ou en milieu scolaire.

Par défaut : Somme des écarts au carré / (n - 1)
Erreur standard de la moyenne (SE)Indicateur de précision d'échantillonnage

Mesure la précision avec laquelle la moyenne de l'échantillon estime la véritable moyenne de la population, calculée par la formule s / √n. Alors que l'écart-type reflète la dispersion naturelle entre observations individuelles (comme la fréquence cardiaque quotidienne au repos), l'erreur standard mesure la fiabilité de la moyenne globale, diminuant à mesure que vous accumulez des séances d'entraînement ou des mesures de santé.

Par défaut : Indice de précision s / √n
Coefficient de variation (CV)Dispersion relative normalisée

Rapport entre l'écart-type et la moyenne exprimé en pourcentage : (s / Moyenne) × 100 %. Offre un étalon sans dimension pour comparer la régularité de grandeurs d'échelles très différentes, comme comparer la variabilité cardiaque pendant le sommeil profond (moyenne de 60 bpm, s = 3 bpm, CV = 5 %) et lors de fractionnés à haute intensité (moyenne de 170 bpm, s = 8,5 bpm, CV = 5 %).

Par défaut : Ratio de volatilité en pourcentage ((s / Moyenne) × 100 %)
Écart interquartile (IQR)Mesure de dispersion non paramétrique

Écart entre le 75e percentile (Q3) et le 25e percentile (Q1), englobant les 50 % centraux de vos données. L'écart interquartile étant insensible aux distorsions extrêmes causées par un bug GPS ponctuel, une erreur de saisie ou un pic de dépenses pendant les vacances, il sert d'étalon clinique et sportif pour identifier les vraies anomalies grâce aux clôtures de Tukey (1,5 × IQR).

Par défaut : Plage des 50 % centraux (Q3 - Q1)

Conseils de pro et bonnes pratiques

Annulation catastrophique dans les formules simplifiées

Évitez d'utiliser la formule de raccourci simplifiée (Σx² - (Σx)² / n) lors du traitement de séries aux valeurs de base élevées et aux écarts infimes, telles que des altitudes GPS de référence (1 842,1 m et 1 842,3 m) ou des chronos de dossard au marathon. La soustraction de deux totaux calculés gigantesques et quasi identiques provoque une perte catastrophique de précision décimale. Calculez toujours la véritable moyenne de l'échantillon d'abord, déterminez l'écart de chaque point individuel, puis élevez ces différences au carré.

Le piège de la règle empirique sur des données asymétriques

La règle empirique classique 68-95-99,7 % suppose impérativement une distribution gaussienne symétrique en cloche. Lors du suivi d'indicateurs de la vie quotidienne naturellement asymétriques — comme l'épargne nette d'un ménage, les heures de récupération entre deux cycles de prépa marathon ou les temps de trajet domicile-travail —, les observations se concentrent près d'un seuil physique infranchissable fixé à zéro. Appliquer ±2 écarts-types sur ces données aboutit à prédire des limites négatives impossibles ; privilégiez alors la médiane et l'écart interquartile (IQR).

Légère sous-estimation de l'écart-type sur petits échantillons

Bien que la correction de Bessel (division par n - 1) rende la variance de l'échantillon (s²) mathématiquement sans biais, l'application de la racine carrée réintroduit un léger biais par défaut sur l'écart-type d'échantillon (s) en raison de l'inégalité de Jensen. Sur de petites séries inférieures à 10 observations — comme le chronométrage de 5 répétitions de sprint ou 7 relevés matinaux consécutifs de tension artérielle —, l'écart-type calculé sous-estime généralement la dispersion réelle de 3 % à 6 %.

Loi des rendements décroissants et taille d'échantillon

Comme l'erreur standard diminue proportionnellement à la racine carrée de la taille d'échantillon (√n), diviser votre marge d'erreur par deux impose de quadrupler vos observations. Passer de 10 à 40 séances de course à pied ou relevés de consommation de carburant réduit l'incertitude de 50 %, mais progresser de 40 à 70 entrées n'apporte qu'un gain marginal de 18 %. Privilégiez la rigueur et la qualité des relevés plutôt que l'accumulation brute de volume.

Pièges courants et dépannage

⚠️L'écart-type d'échantillon affiche une valeur indéfinie ou division par zéro

Le calcul de l'écart-type d'échantillon exige au moins deux observations distinctes (n ≥ 2), car la correction de Bessel divise par (n - 1). Avec une seule valeur saisie (n = 1), les degrés de liberté tombent à zéro, rendant la variance mathématiquement indéterminée. Passez en mode Population si vous analysez un événement unique et exhaustif (où N = 1, σ = 0), ou ajoutez d'autres observations à votre échantillon.

⚠️L'écart-type est strictement égal à zéro (s = 0)

Un écart-type nul indique que toutes les valeurs saisies sont rigoureusement identiques (par exemple quatre tours de piste bouclés en exactement 62,0 secondes). Bien que mathématiquement valide, cette absence totale de dispersion empêche le calcul de formules normalisées dérivées comme le coefficient de variation ou les scores Z, provoquant une division par zéro.

⚠️Des performances de pointe légitimes sont signalées à tort comme aberrantes

Les filtres classiques signalent toute observation située au-delà de 1,5 × IQR comme anormale, en supposant une courbe de Gauss symétrique. Dans la pratique sportive ou le quotidien — comme une accélération volontaire lors d'un sprint fractionné ou un pic hivernal sur la facture de chauffage —, les distributions à queue épaisse sont tout à fait naturelles. Rehaussez le seuil à 3,0 × IQR (clôtures externes extrêmes) ou vérifiez votre carnet d'entraînement avant d'éliminer des données réelles.

⚠️La borne inférieure de l'intervalle de confiance passe sous le zéro physique

Les intervalles de confiance symétriques (Moyenne ± Marge d'erreur) supposent une variation égale de part et d'autre de la moyenne. Quand la moyenne est faible et la dispersion relative forte — comme le comptage hebdomadaire d'entraînements manqués ou de pannes mécaniques —, le calcul peut donner une borne inférieure négative. Bloquez la borne inférieure à zéro ou utilisez la médiane et les percentiles non paramétriques pour les grandeurs physiques strictement positives.

Foire aux questions (FAQ)

Comment calculer l'écart-type étape par étape ?▼

Pour calculer l'écart-type d'un échantillon, calculez la moyenne arithmétique, soustrayez cette moyenne de chaque valeur, élevez chaque écart au carré, additionnez tous ces carrés, divisez la somme obtenue par n - 1 (correction de Bessel), puis calculez la racine carrée positive : s = √[ Σ(x - Moyenne)² / (n - 1) ]. Par exemple, avec les valeurs 4, 8 et 12, la moyenne est de 8 ; les carrés des écarts à la moyenne valent 16, 0 et 16 (soit une somme de 32) ; la division par (3 - 1 = 2) donne une variance de 16, ce qui donne un écart-type de 4.

Qu'est-ce qu'un écart-type satisfaisant ou normal ?▼

Un bon écart-type s'évalue toujours par rapport à l'échelle de la moyenne, mesurée par le coefficient de variation (CV = s / Moyenne × 100 %). Pour la régularité d'allure en course à pied ou les constantes physiologiques au repos, un CV inférieur à 5 % ou 8 % témoigne d'une excellente constance, alors qu'une fourchette de 10 % à 15 % est courante chez les coureurs amateurs. Dans l'industrie de précision ou le dosage pharmaceutique, un CV sous 1 % à 2 % est requis, tandis que les actifs financiers volatils affichent fréquemment des écarts-types dépassant 30 % de leur moyenne.

Quelle est la différence entre écart-type et variance ?▼

La variance mesure la dispersion moyenne en unités au carré (comme des secondes² ou des euros²), alors que l'écart-type est la racine carrée de la variance, ce qui restitue la dispersion dans l'unité d'origine exacte de vos données (comme des secondes ou des euros). Si la variance est un outil mathématique incontournable pour les analyses ANOVA et la modélisation statistique, l'écart-type offre une mesure concrète et immédiatement comparable à vos relevés du quotidien.

Quelle est la différence entre écart-type et erreur standard ?▼

L'écart-type mesure la variabilité naturelle des observations individuelles au sein d'une série de données, tandis que l'erreur standard de la moyenne (SE = s / √n) quantifie la proximité entre la moyenne de votre échantillon et la véritable moyenne de la population. L'écart-type décrit la dispersion intrinsèque des données et reste stable quand l'échantillon s'agrandit, alors que l'erreur standard traduit la précision de l'estimation et tend progressivement vers zéro à mesure que vous collectez des mesures.

Pourquoi diviser par n moins 1 plutôt que par n pour l'écart-type d'un échantillon ?▼

On divise par n - 1 (correction de Bessel) parce que les observations d'un échantillon ont tendance à se regrouper plus près de leur propre moyenne que de la véritable moyenne de la population globale. Estimer la moyenne à partir des données impose une contrainte algébrique (la somme des écarts est nulle), ce qui consomme un degré de liberté. Diviser par n sous-estime systématiquement la dispersion de la population réelle ; diviser par n - 1 compense ce biais pour fournir un estimateur fidèle et sans biais.

Outils et utilitaires connexes

Tous les outils →